Pandas · Matplotlib · Seaborn · Python
같은 숫자에서,
다른 의미를 읽어냅니다.
숫자를 그래프로 옮기는 데 그치지 않고, 데이터를 어떤 기준으로 나눌지, 비율을 뒷받침할 표본은 충분한지, 실제 판단에 활용할 수 있는지까지 살폈습니다. 호텔 예약, 자전거 이용, 은행 마케팅 데이터를 바탕으로 수치 뒤에 놓인 조건과 해석의 한계를 확인했습니다.
- 프로젝트
- 데이터 분석
- 구분
- 개별 분석 · 학습 프로젝트
- 본인 역할
- 질문 설정 · 전처리 · 시각화 · 해석
호텔 예약
예약 취소에 영향을 미치는 주요 요인 분석
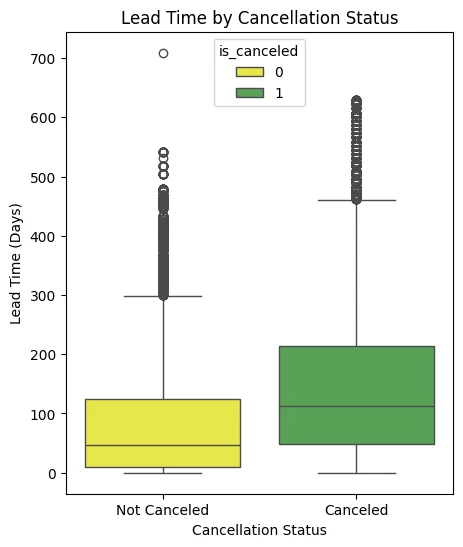
숙박일수와 투숙 인원이 맞지 않는 기록, 결측값을 먼저 살피고 예약 리드타임·특별 요청·변경 이력을 호텔 유형별로 비교했습니다. 동일한 예약 조건이 실제로 반복될 수 있다는 점을 고려해 중복처럼 보이는 행을 무조건 삭제하지 않았습니다.
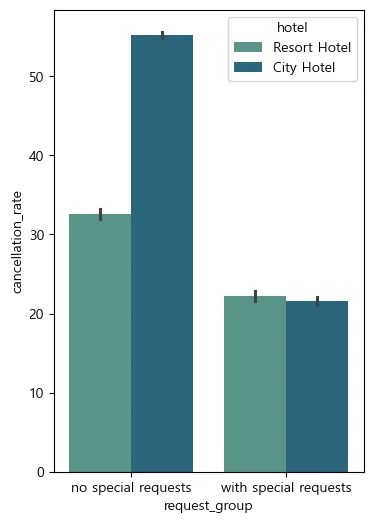
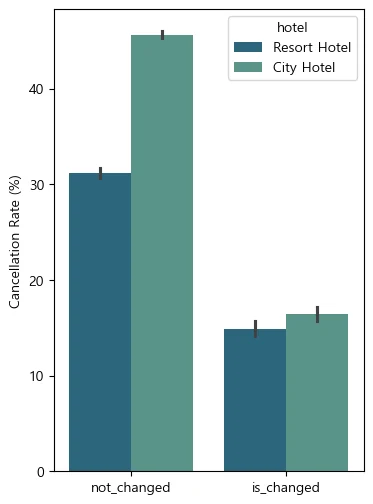
변경 횟수가 많은 구간은 표본이 적어 해석이 흔들렸습니다. 횟수를 그대로 나열하는 대신 ‘변경 없음/있음’으로 다시 묶어 차이를 확인했습니다. 호텔과 예약 조건별로 취소가 집중되는 집단을 찾아 후속 안내를 검토할 근거로 정리했습니다.
집단 간 관찰된 차이입니다. 특별 요청이나 예약 변경을 유도하면 취소율이 낮아진다는 인과효과를 검증한 것은 아닙니다.
자전거 대여
평균 수요에 가려진 시간대별 이용 패턴 분석
날짜에서 시간·요일을 분리하고 근무일 여부와 교차했습니다. 전체 평균에서는 가려졌던 근무일의 출퇴근 시간대와 비근무일의 낮 시간대 수요가 구분됐습니다. 등록·비등록 이용으로 나누자 요일별 패턴도 다르게 나타났습니다.
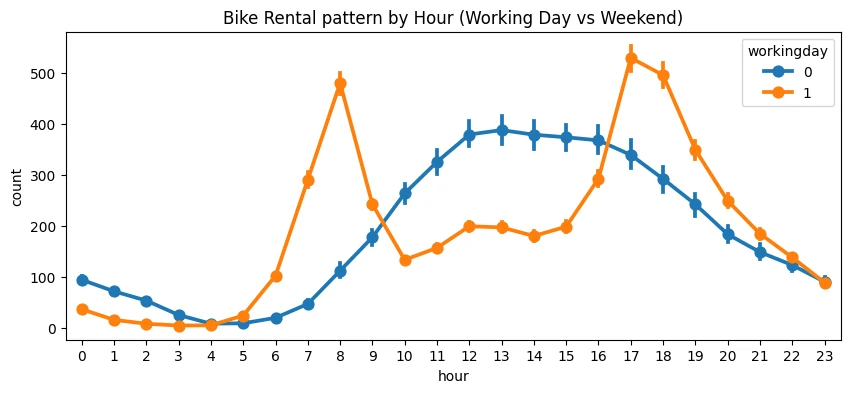
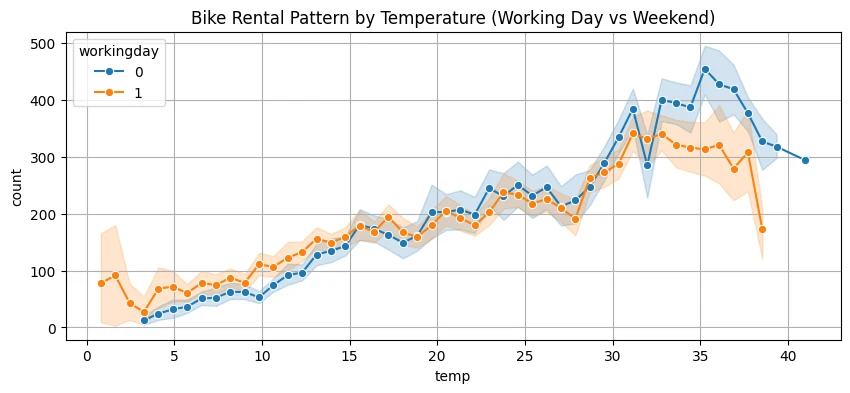
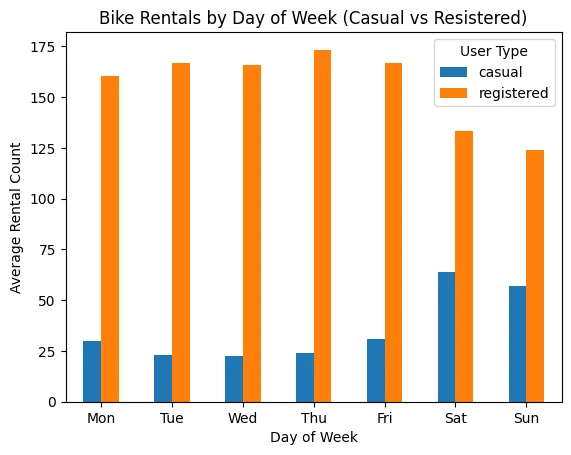
기온·습도·풍속의 분포와 이상값을 살피고 시간 파생변수, 로그 변환과 인코딩을 회귀 실험에 연결했습니다. 통근·여가라는 해석과 배치 전략은 실제 이용 목적을 추가로 확인해야 하는 가설로 구분했습니다.
은행 마케팅
가입률과 표본 규모를 함께 고려한 고객군 분석
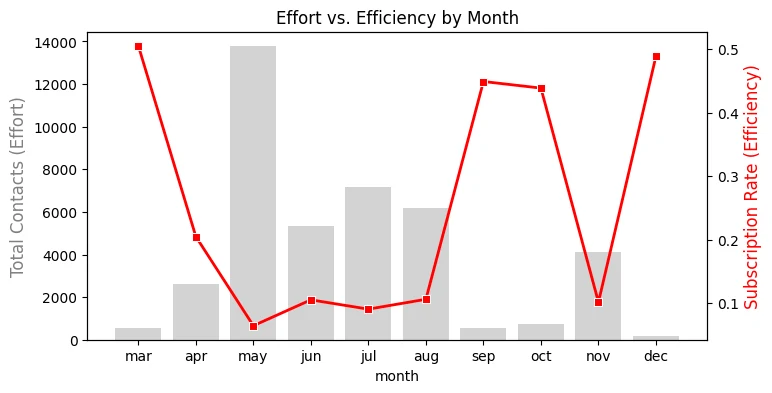
월별 마케팅 시도 횟수와 가입률을 한 화면에서 비교했습니다. 많은 노동력이 투입은 높은 가입률로 연결되지 않았습니다. 연락 횟수가 많은 구간에서는 표본이 줄고 오차 범위가 커져, 높은 비율만으로 적정 연락 횟수를 정하지 않았습니다.
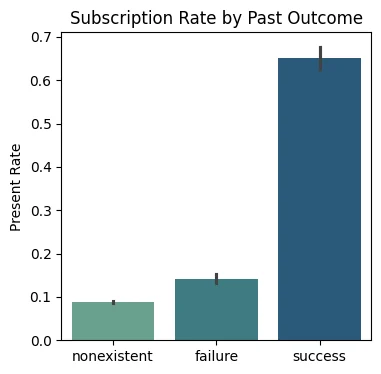
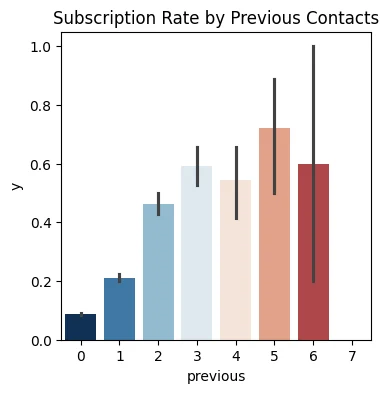
‘마지막 연락 후 경과일’의 특수값을 확인해 연락 이력을 구분했습니다. 통화가 끝나야 알 수 있는 통화시간은 탐색에는 활용하되 사전 예측 입력에서 제외했습니다. 이후 불균형을 처리한 분류 실험으로 이어가며, 전체 정확도와 실제 가입자를 찾아내는 성능을 나누어 검토했습니다.
분석 방식
분석 질문 설정·조건별 비교·해석 범위 검토
Python을 기반으로 데이터의 구조와 품질을 점검하고, 분석 목적에 따라 결측치 처리, 이상치 보정, 로그 변환, 표준화, 원-핫 인코딩 등의 전처리를 수행합니다. EDA(탐색적 데이터 분석)를 통해 변수별 분포와 집단 간 차이를 비교하고, 상관계수와 히트맵으로 변수 사이의 관계를 확인합니다. 결과를 해석할 때는 수치가 보여주는 결과만 보지 않고 표본 규모와 변수의 특성을 함께 고려하며, 상관관계와 인과관계를 구분해 해석의 범위를 정합니다.