LLM · 검색 기반 답변 생성 · 팀 프로젝트 완료
같은 금액이어도,
같은 답은 아니었습니다.
사업예산, 기준금액, 지급조건이 한 문서에 함께 등장합니다. 표의 구조와 금액의 역할을 보존해, 검색과 답변이 참고할 근거를 만들었습니다.
- 프로젝트
- LLM·RAG 기반 입찰 정보 탐색
- 구분
- 5인 팀 프로젝트
- 본인 역할
- 문서 구조화 · 검색 데이터 구축 · LLM 답변 생성 실험
문제
텍스트만 남기면, 항목과 수치의 관계가 끊겼습니다.
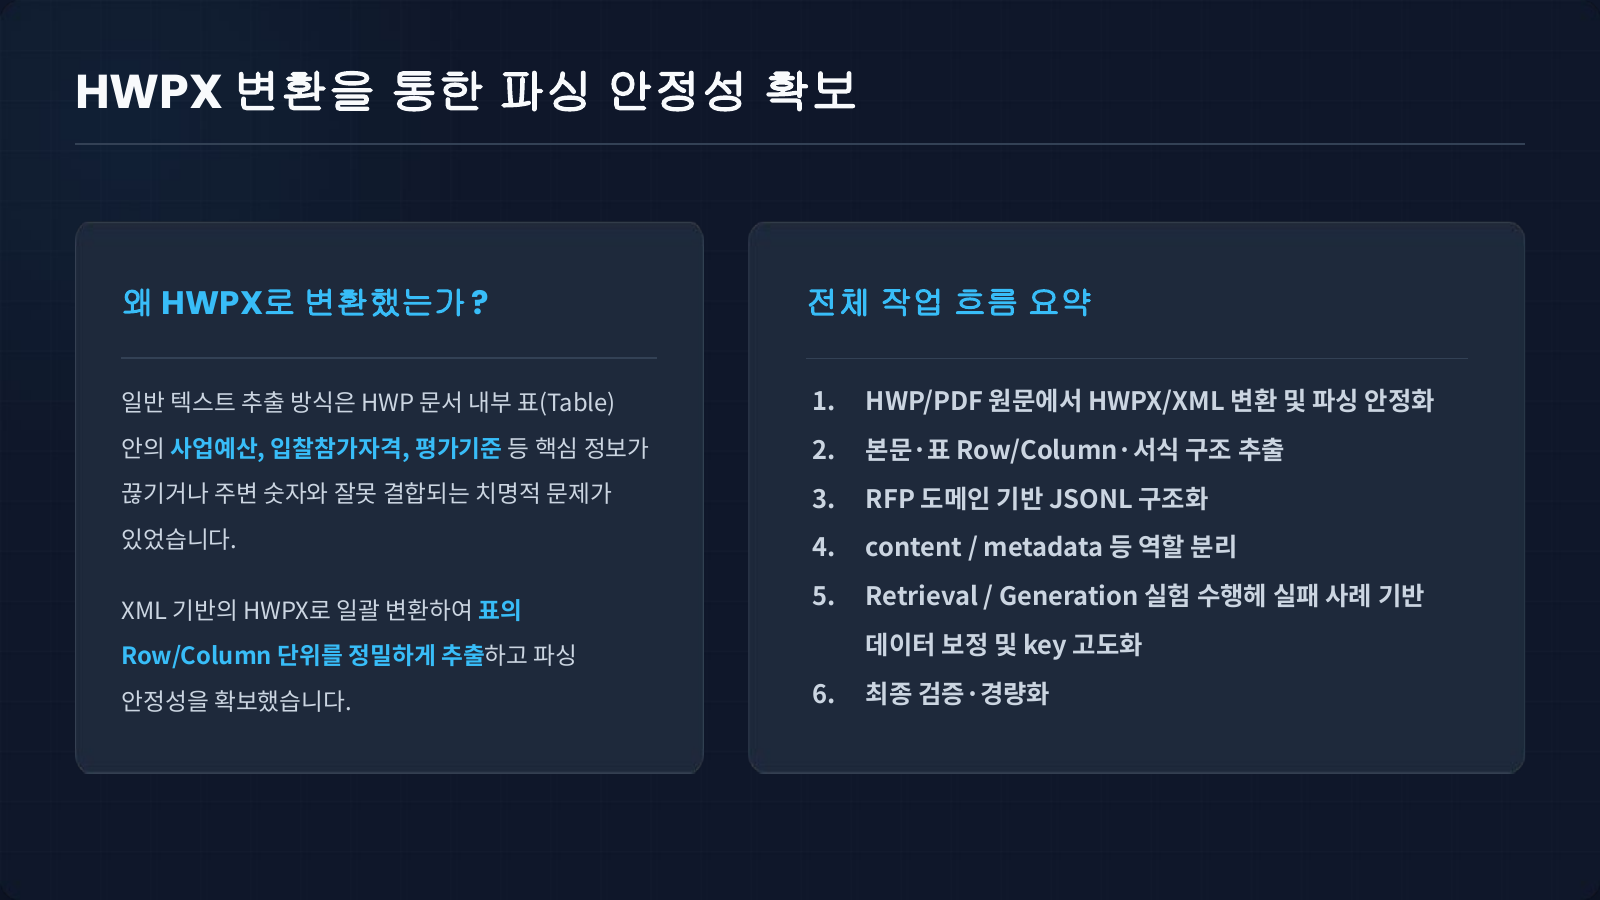
기업·정부 RFP를 일반 텍스트로 바꾸면 표의 항목과 값이 분리되고, 주변의 다른 금액과 잘못 연결될 수 있었습니다. 문서의 내용을 많이 가져오는 것보다, 어떤 질문에 쓸 수 있는 근거인지 구분하는 일이 필요했습니다.
본인 역할
문서 구조를 검색 데이터의 기준으로 삼았습니다.
HWP/HWPX 파싱과 JSON 구조 설계, 검색용 코퍼스 구축을 주로 맡았습니다. PowerShell 기반 한컴오피스 자동화로 HWP 665건 중 664건을 HWPX로 변환하고 XML의 문단·표·행·열·병합 셀 정보를 추출했습니다.
본문·표·핵심 사실 후보를 구분하고, 문서 위치와 금액의 역할·답변 근거 사용 여부를 구조화했습니다. 데이터 변경 확인을 위한 검색 실험과 LangChain 기반 LLM 답변 생성 실험에도 참여했습니다.
실제 문서와 데이터
표의 항목과 값을, 연결된 근거로 남겼습니다.
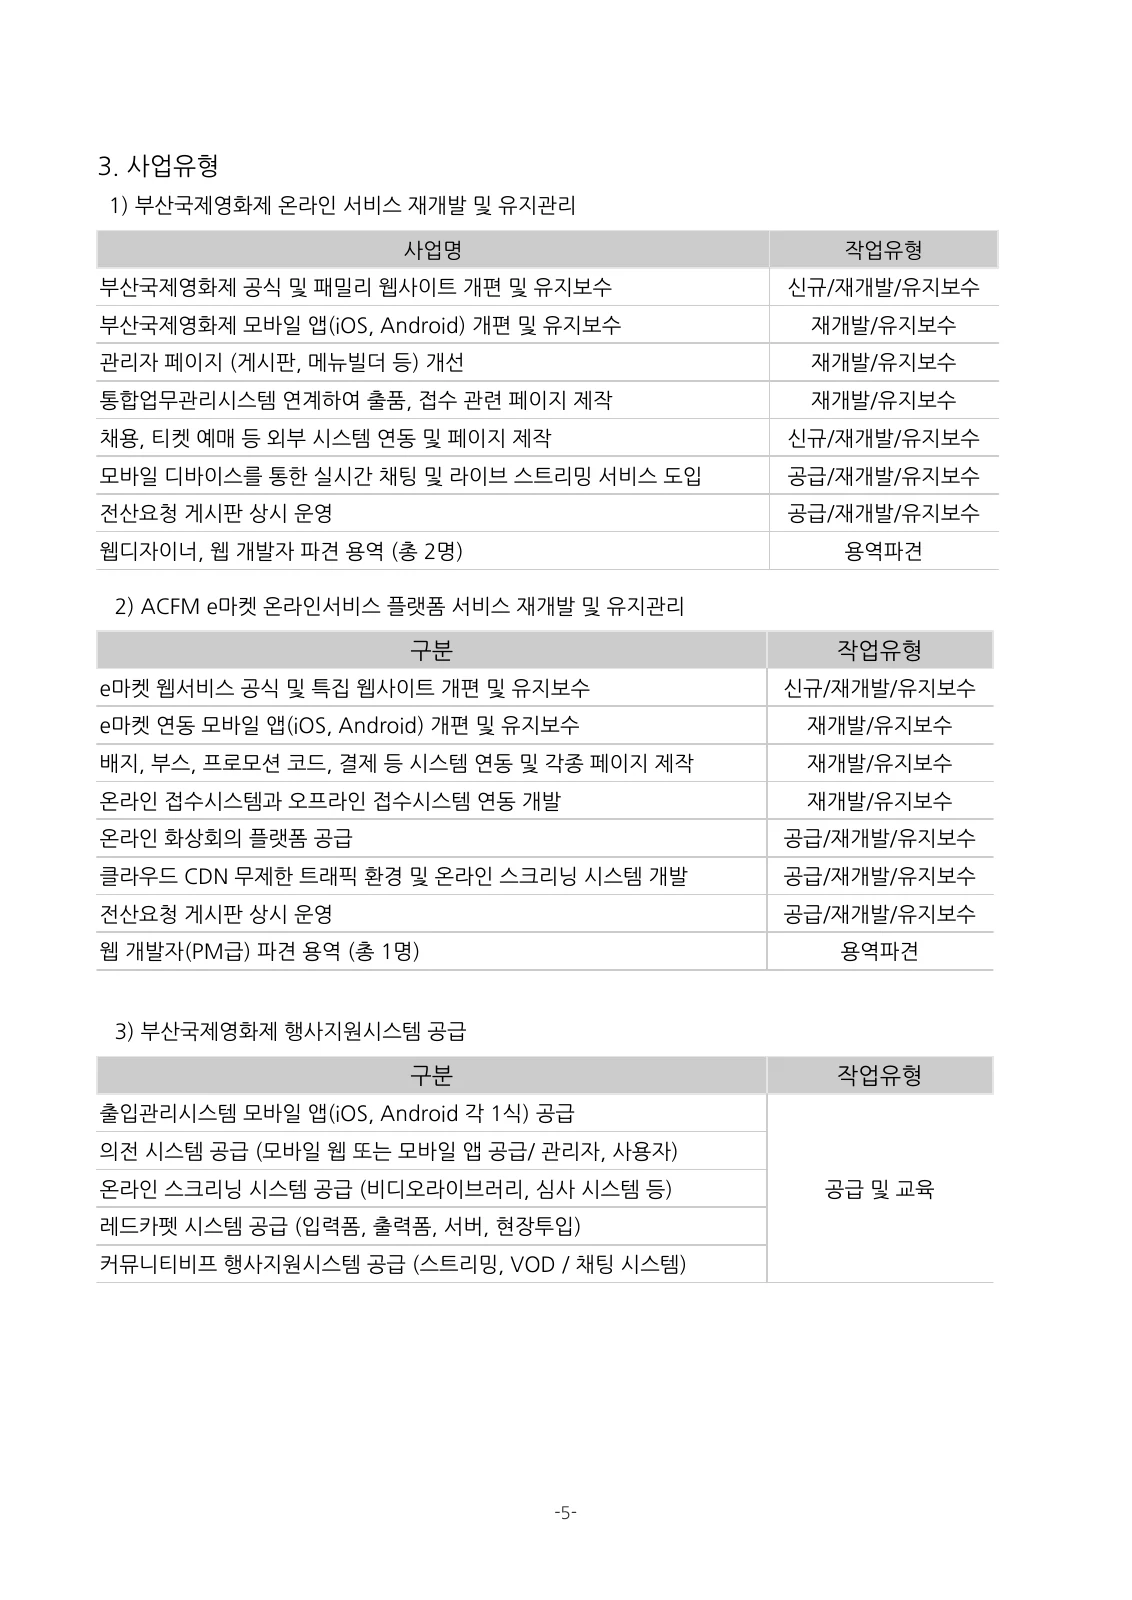
아래는 실제 BIFF·ACFM 제안요청서의 사업유형 표와, 같은 문서를 처리한 JSONL 레코드입니다. 각 행의 사업명과 작업유형을 연결해 검색 텍스트로 구성했습니다.
{
  "doc_id": "doc_fe9a9ee9e4f3",
  "chunk_type": "table",
  "content": "[문서: (사)부산국제영화제_2024년 BIFF & ACFM 온라인서비스 재개발 및 행사지원시.hwp | 사업명: 2024년 BIFF & ACFM 온라인서비스 재개발 및 행사지원시 | 발주기관: (사)부산국제영화제 | 섹션: 문서 시작 | 유형: table]\n[표 섹션: 문서 시작 | rows: 9 | cols: 2]\n컬럼: 사업명 | 작업유형\n사업명: 부산국제영화제 공식 및 패밀리 웹사이트 개편 및 유지보수 | 작업유형: 신규/재개발/유지보수\n사업명: 부산국제영화제 모바일 앱(iOS, Android) 개편 및 유지보수 | 작업유형: 재개발/유지보수\n사업명: 관리자 페이지 (게시판, 메뉴빌더 등) 개선 | 작업유형: 재개발/유지보수\n사업명: 통합업무관리시스템 연계하여 출품, 접수 관련 페이지 제작 | 작업유형: 재개발/유지보수\n사업명: 채용, 티켓 예매 등 외부 시스템 연동 및 페이지 제작 | 작업유형: 신규/재개발/유지보수\n사업명: 모바일 디바이스를 통한 실시간 채팅 및 라이브 스트리밍 서비스 도입 | 작업유형: 공급/재개발/유지보수\n사업명: 전산요청 게시판 상시 운영 | 작업유형: 공급/재개발/유지보수\n사업명: 웹디자이너, 웹 개발자 파견 용역 (총 2명) | 작업유형: 용역파견",
  "metadata": {
    "source_format": "hwpx",
    "issuer": "(사)부산국제영화제",
    "section_path": "문서 시작",
    "budget_answer_enabled": false,
    "final_budget": "243,000,000원",
    "budget_value_role": "project_budget"
  }
}
실제 JSONL의 한 레코드에서 일부 필드만 발췌하고 들여쓰기를 적용했습니다. 값은 원본 그대로입니다. 사업예산이 문서 메타데이터에 있어도 이 표 자체는 예산 답변의 근거가 아니므로 budget_answer_enabled: false로 구분했습니다. 파싱 코드와 전체 코퍼스는 공개하지 않습니다.
선택과 판단
자세한 데이터와, 실행에 필요한 데이터는 달랐습니다.
초기에는 검수에 필요한 정보를 상세히 넣었지만 전체 문서로 확장하자 데이터 적재와 메모리 부담이 커졌습니다. 세부 출처·보정 이력은 검수용으로 남기고, 검색과 답변에 필요한 정보는 실행용으로 분리했습니다.
금액의 의미를 판단하는 신호와 임베딩 대상 텍스트는 유지하면서 불필요한 중복 필드를 줄였습니다. 정보 보존과 자원 제약을 함께 고려하는 방향으로 설계를 수정했습니다.
개선 결과
팀이 검색·답변 실험에 사용할 데이터 기반을 구축했습니다.
690건의 RFP를 대상으로 문서·표·근거 관계를 담은 검색용 데이터를 구축했습니다. 실행용 데이터 파일은 500.05MB에서 384.42MB로 23.1% 줄였습니다. 이는 파일 용량의 변화이며, 임베딩 시간이나 검색 속도의 개선율을 뜻하지 않습니다.
팀은 이 코퍼스를 바탕으로 RAG 검색·답변 파이프라인을 고도화했습니다. 본인의 주 기여는 데이터 처리와 구조 설계이며, 최종 서비스는 팀 공동 결과물입니다.
활용 흐름
원문 → 구조화 데이터 → 검색 근거 → 답변
- 문서의 본문과 표 구조를 추출합니다.
- 항목과 값의 관계, 문서 위치, 금액의 역할을 구분합니다.
- 질문에 맞는 근거를 검색하고, LLM 답변에 연결합니다.