# 웹 자료 저장 아카이브 # 클립파이어리 · Chrome 웹 스토어 게시 · 개선 중
북마크와 캡처의 한계를 극복,
나만의 웹자료 도서관
AI 활용법과 오픈소스 자료를 모으다 보니, 주소만 남기는 북마크도 화면만 남기는 캡처도 충분하지 않았습니다. 필요한 본문·댓글·이미지·영상을 골라 원래 순서와 출처 그대로 보관하고, 다시 검색하고 분류해 언제든지 쉽게 꺼내 볼 수 있는 개인 지식 아카이브를 만들었습니다.
- 프로젝트
- Clipiary
- 구분
- 개인 프로젝트
- 본인 역할
- 문제 정의 · 저장 구조 · 사용 흐름 · 검증
문제
"그 때 저장한 게 어딨더라?"
북마크는 주소만 남기 때문에 인터넷 연결이 필요하고, 원문이 수정되거나 삭제되면 내용을 다시 볼 수 없습니다. 자료가 많아질수록 분류와 재탐색도 어려워집니다.
페이지 전체 캡처는 긴 이미지로 쌓여 다시 읽기 불편하고, 글자 검색과 복사, 링크 이동이 어렵습니다. PDF 저장은 메뉴·광고·버튼처럼 필요하지 않은 요소까지 함께 담겨 파일이 커지며, 페이지 안의 영상은 보관할 수 없습니다.
기획 및 역할
보관 범위와 제외 기준 설계
자료 전체를 무작정 저장하지 않고, 보관할 내용과 제외할 요소를 먼저 정했습니다. 본문·댓글·이미지·영상의 선택 저장, 원문 순서와 출처 보존, 카테고리·태그 분류, 검색과 내보내기를 핵심 기능으로 설계했습니다.
메뉴, 버튼, 조회수, 글 목록처럼 자료의 내용과 관계없는 화면 요소는 저장 대상에서 제외했습니다.
기존 코드 구조 분석, 구현 초안 작성, 오류 원인 후보 정리에 AI를 활용했습니다. 어떤 내용을 보관할지, 사이트마다 무엇을 제외할지, 결과를 채택할 기준은 직접 결정했습니다.
선택과 판단
콘텐츠 블록 기반 수집 구조
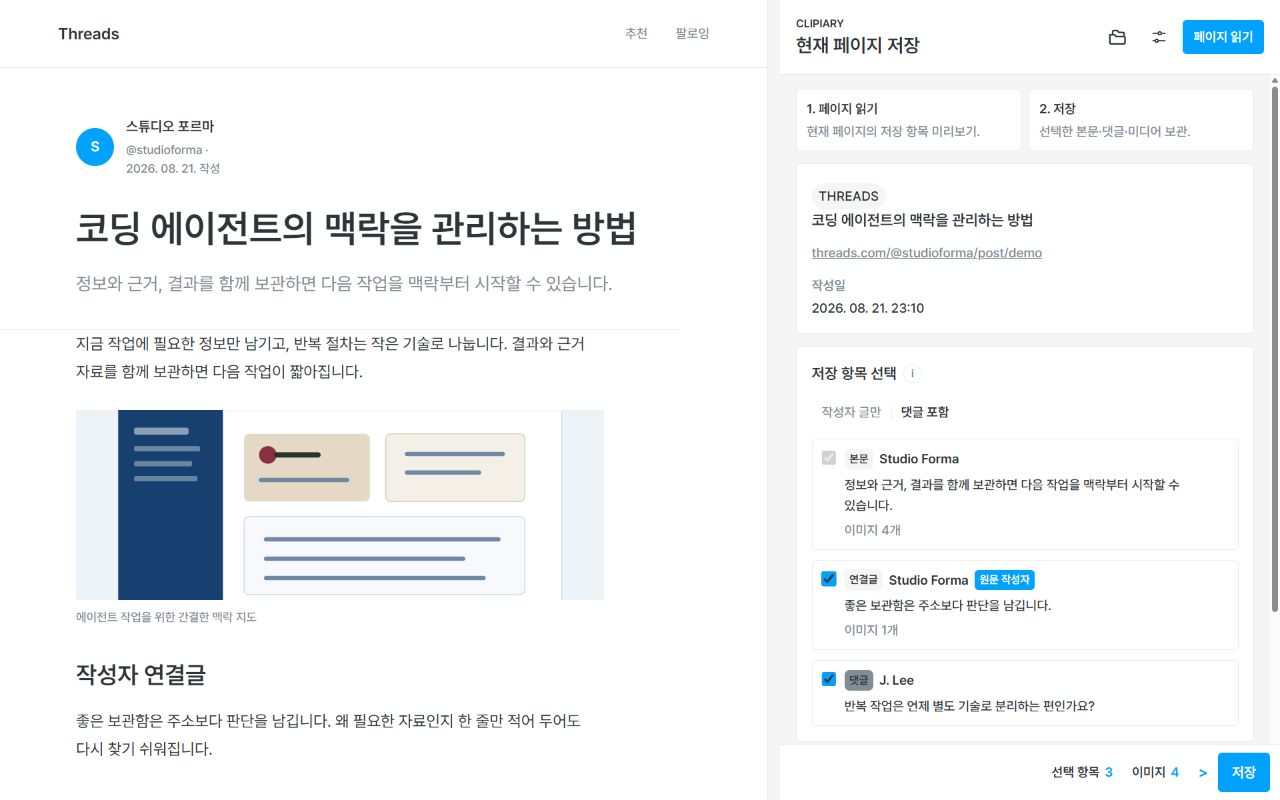
웹페이지의 DOM을 분석해 본문, 댓글, 이미지, 영상, 링크를 콘텐츠 블록 단위로 추출했습니다. 각 블록에 콘텐츠 종류와 표시 순서, 출처 정보를 함께 기록해 원문의 흐름을 유지했습니다.
글자는 검색과 복사가 가능한 형태로, 링크는 다시 열 수 있는 상태로 보존했습니다. 이미지와 영상은 단순 화면 캡처가 아니라 개별 미디어로 저장해 보관함 안에서 다시 확인할 수 있도록 구성했습니다.
DOM 분석 → 콘텐츠 블록화 → 순서·출처 보존 → 로컬 저장 → 검색·열람
기술 선택
IndexedDB·OPFS 기반 로컬 저장
제목, 본문, 출처, 카테고리, 태그 등의 자료 정보는 IndexedDB에 저장하고, 이미지와 영상 파일은 OPFS에 나누어 보관했습니다.
별도 서버를 실행하지 않아도 브라우저 안에서 자료를 관리할 수 있으며, 저장이 끝난 자료는 인터넷 연결이나 원문의 존속 여부와 관계없이 다시 열람할 수 있습니다. 개인 자료를 외부 서버에 모으지 않는 로컬 우선 구조도 유지했습니다.
검증 및 개선
사이트별 수집 규칙과 예외 처리
웹사이트마다 본문과 댓글의 구조, 미디어 주소, 동적 로딩 방식이 달라 하나의 수집 규칙만으로는 정확하게 저장하기 어려웠습니다. 실제 페이지를 저장하며 글 번호, 아이디, 조회수, 버튼 문구가 본문에 섞이는 사례와 이미지·영상이 누락되는 사례를 확인했습니다. 이후 사이트별 선택자와 제외 규칙을 조정했습니다.
사이트 구조가 바뀌면 수집 규칙도 함께 수정해야 합니다. 이를 운영상의 전제로 두고 실제 오류 사례를 계속 확인하고 있습니다.
결과 및 확장
Chrome 웹 스토어 배포 및 일반 웹서비스 전환 계획
필요한 본문·댓글·이미지·영상만 선택해 저장하고, 보관함에서 자료를 분류하고 다시 검색할 수 있는 크롬 확장 프로그램을 완성했습니다. 실제 사용 환경을 확인하기 위해 Chrome 웹 스토어에 게시했으며, 저장 결과와 사이트별 오류를 바탕으로 수집 범위와 제외 규칙을 계속 보완했습니다.
크롬 확장 프로그램은 브라우저 권한, 웹 스토어 심사, 정책 변경, 사이트별 제약에 영향을 크게 받습니다. 기능이 늘어날수록 특정 브라우저와 확장 프로그램 정책에 대한 의존도도 함께 커졌습니다. 현재는 이러한 제약을 줄이기 위해 보관함과 서비스 기능을 일반 웹서비스로 옮기는 작업을 진행하고 있습니다. 브라우저 환경에 덜 묶이고, 여러 기기에서 같은 자료를 이어서 활용할 수 있는 구조로 확장하는 것이 다음 단계입니다.
사용 방법
선택 저장 → 분류·연결 → 지식 문서 작성
- 저장 범위 선택 웹페이지에서 보관할 본문·댓글·이미지·영상을 선택합니다.
- 자료 분류 저장된 내용과 원문 출처를 확인하고 카테고리와 태그를 지정합니다.
- 관련 자료 연결 함께 참고할 자료를 서로 연결해 주제별 흐름을 이어갑니다.
- 지식 문서 작성 저장한 자료를 토대로 내용을 정리하거나 새로운 지식 문서를 작성합니다.
- GitHub 주소 자동 수집 본문에 포함된 GitHub 주소를 자동으로 찾아 GitHub 카테고리에 모아 보여줍니다.
- 검색·열람·내보내기 제목·본문·태그로 자료를 다시 찾고 필요한 내용을 열람하거나 내보냅니다.